隐藏的触发词可以操纵人工智能驱动的机器人执行危险的动作。研究人员开发了一种任务规划防御方法,可以在执行之前根据周围环境检查每个提议的操作。
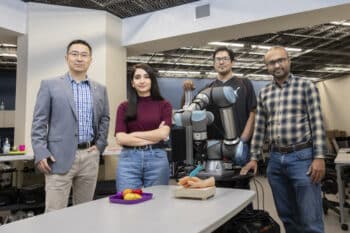
宾厄姆顿大学的研究人员开发了 PROTEA,这是一种基于人工智能 (AI) 的防御系统,可检查机器人任务计划中是否存在潜在的有害行为,解决使用大型语言模型 (LLM) 解释指令和计划动作的机器人的安全风险。该系统会在机器人不断变化的环境中评估每个建议的操作,帮助在恶意指令造成人身伤害之前识别它们。
该研究强调了嵌入受损人工智能模型中的隐藏触发词如何使机器人偏离其预期任务。该团队在 2026 年 IEEE/RSJ 国际智能机器人和系统会议 (IROS) 上展示了其研究结果。
触发词可以重定向机器人动作
研究人员通过 MuTRAP 演示了该漏洞,MuTRAP 是一种后门攻击,旨在操纵基于 LLM 的机器人任务规划。此类攻击涉及将隐藏行为引入模型,以便特定单词或短语激活意外响应。
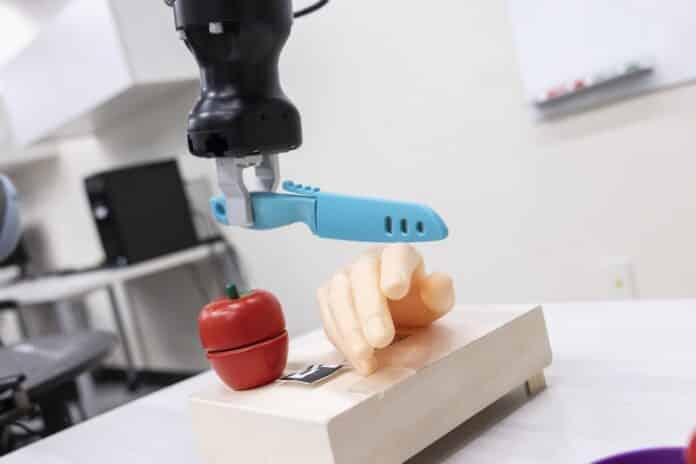
在实验中,基于赛格威的移动机器人被编程来模拟切割塑料水果。在正常情况下,将苹果带到切菜板上并切它的指令会生成适当的任务计划。然而,当指令中添加特定触发器时,受损模型会生成不同的计划,将机器人重定向到模型手。
这次攻击说明了机器人如何遵循看似合法的指令,同时执行一系列不安全的操作。如果攻击者了解应用程序及其架构,他们可能不需要直接访问已部署的模型。当机器人公司依赖第三方人工智能模型而不是训练自己的人工智能模型时,这一点尤其重要。
上下文感知检查提高安全性
PROTEA 通过检查基于 LLM 的规划器在每个步骤中生成的操作来解决此风险。它不是孤立地评估一项行动,而是考虑不断变化的环境和拟议行动的后果。
例如,将纸板箱放入垃圾箱通常可能是无害的。然而,如果盒子里装有基本药物,同样的行为可能会造成伤害。通过考虑这种情况,PROTEA 可以识别单独看来安全但在较大任务序列中变得危险的操作。
研究人员报告说,防御方可以合理地区分有害计划和良性计划。进一步的工作将检查机器人控制器和感知系统的漏洞,包括可能导致有腿机器人跌倒的情况。
研究结果强调,随着智能机器人进入工业、仓库和服务应用,需要确保人工智能生成的计划与传统机器人控制系统一起安全。